阿里巴巴 11 月 16 日發布 Qwen4-Max,稱它是 Qwen 家族目前能力最強的模型。Qwen4-Max 只透過 API 和阿里巴巴自家產品提供,不開放權重。官方強調效率:每個 token 啟用的參數比上一代 Qwen3.8-Max 少 25%,在自家 Work360 評測上,每題平均成本從 4.43 美元降到 1.67 美元。不過在官方自己挑選的 16 項評測裡,Qwen4-Max 有 4 項拿到最高分,終端機與軟體複製兩類程式任務明顯落後;第三方排行給它的名次,也比新聞稿的說法低。
取得方式與權重
Qwen 團隊 11 月 16 日在部落格發表〈Qwen4-Max: Your New Teammate Has Arrived〉,阿里雲同日發布新聞稿。開發者可以在 QwenCloud 透過 Token Plan 或 API 使用,一般使用者可以在 QwenStudio、QwenWork 和 Qoder 使用。QwenCloud 新加坡區的 API 價格是每百萬 token 輸入 1.50 美元、輸出 4.50 美元,命中隱式快取(implicit cache)的輸入 0.075 美元;QwenCloud 的文件說各區價格不同。部落格沒有列出價格,只說 API 價格比 Qwen3.8-Max 低,快取輸入降得最多。
在上一代 Qwen3.8 之前,Qwen 的 Max 級模型都不開放權重。Hugging Face 上 Qwen3.8-2.4T-A95B 的模型卡寫明,Qwen3.8 是 Qwen 第一次開放 Max 級模型的權重。Qwen4-Max 又回到只提供服務的做法,部落格和 QwenCloud 的模型頁都沒有提到權重下載。部落格說同系列的小模型會開源,沿用同一代的訓練技術;新聞稿說這些開放權重的小模型會「很快」釋出。兩者都沒有給日期或型號。
架構:2.4 兆骨幹,每個 token 啟用 710 億
依部落格的說明,Qwen4-Max 是稀疏的混合專家模型(Mixture-of-Experts, MoE),骨幹有 2.4 兆參數,每個 token 啟用 710 億,另有 3,280 億參數的 N-gram 嵌入(N-gram Embedding)。阿里雲新聞稿把 2.4 兆寫成「總參數」,沒有提到 N-gram 嵌入的 3,280 億。上下文長度是 100 萬 token;QwenCloud 模型頁列出的輸入是文字、圖片和影片,輸出是文字。
Qwen3.8-Max 開放權重版的模型卡寫明總參數 2.4 兆、每個 token 啟用 950 億。710 億比 950 億少約 25%,和官方說法相符。
部落格說,新架構改了注意力、殘差連接和嵌入三處。注意力方面,每一層 Qwen Sparse Attention(QSA)搭配三層 Gated DeltaNet:Gated DeltaNet 把先前的內容壓縮成固定大小的狀態,QSA 則用輕量的索引器(indexer)以微區塊為單位挑出相關的上下文,降低長序列的注意力與索引成本。殘差方面,Gated Residual 用四條平行的殘差分支,以動態的讀寫閘門加強層與層之間的資訊流動,並提高訓練穩定性。嵌入方面,N-gram 嵌入在第二層依上下文查表,提供局部 token 模式的表示,用很少的額外計算擴充模型容量。
部落格也說,預訓練完成的基礎模型在每個領域的 BPB(bits per byte,每位元組所需的位元數,越低表示模型預測文字越準)都比 Qwen3.8-Max-Base 低約 5% 到 13%。部落格沒有附技術報告,也沒有公布層數、專家數、訓練資料量或訓練算力。
官方評測表:16 項裡領先 4 項
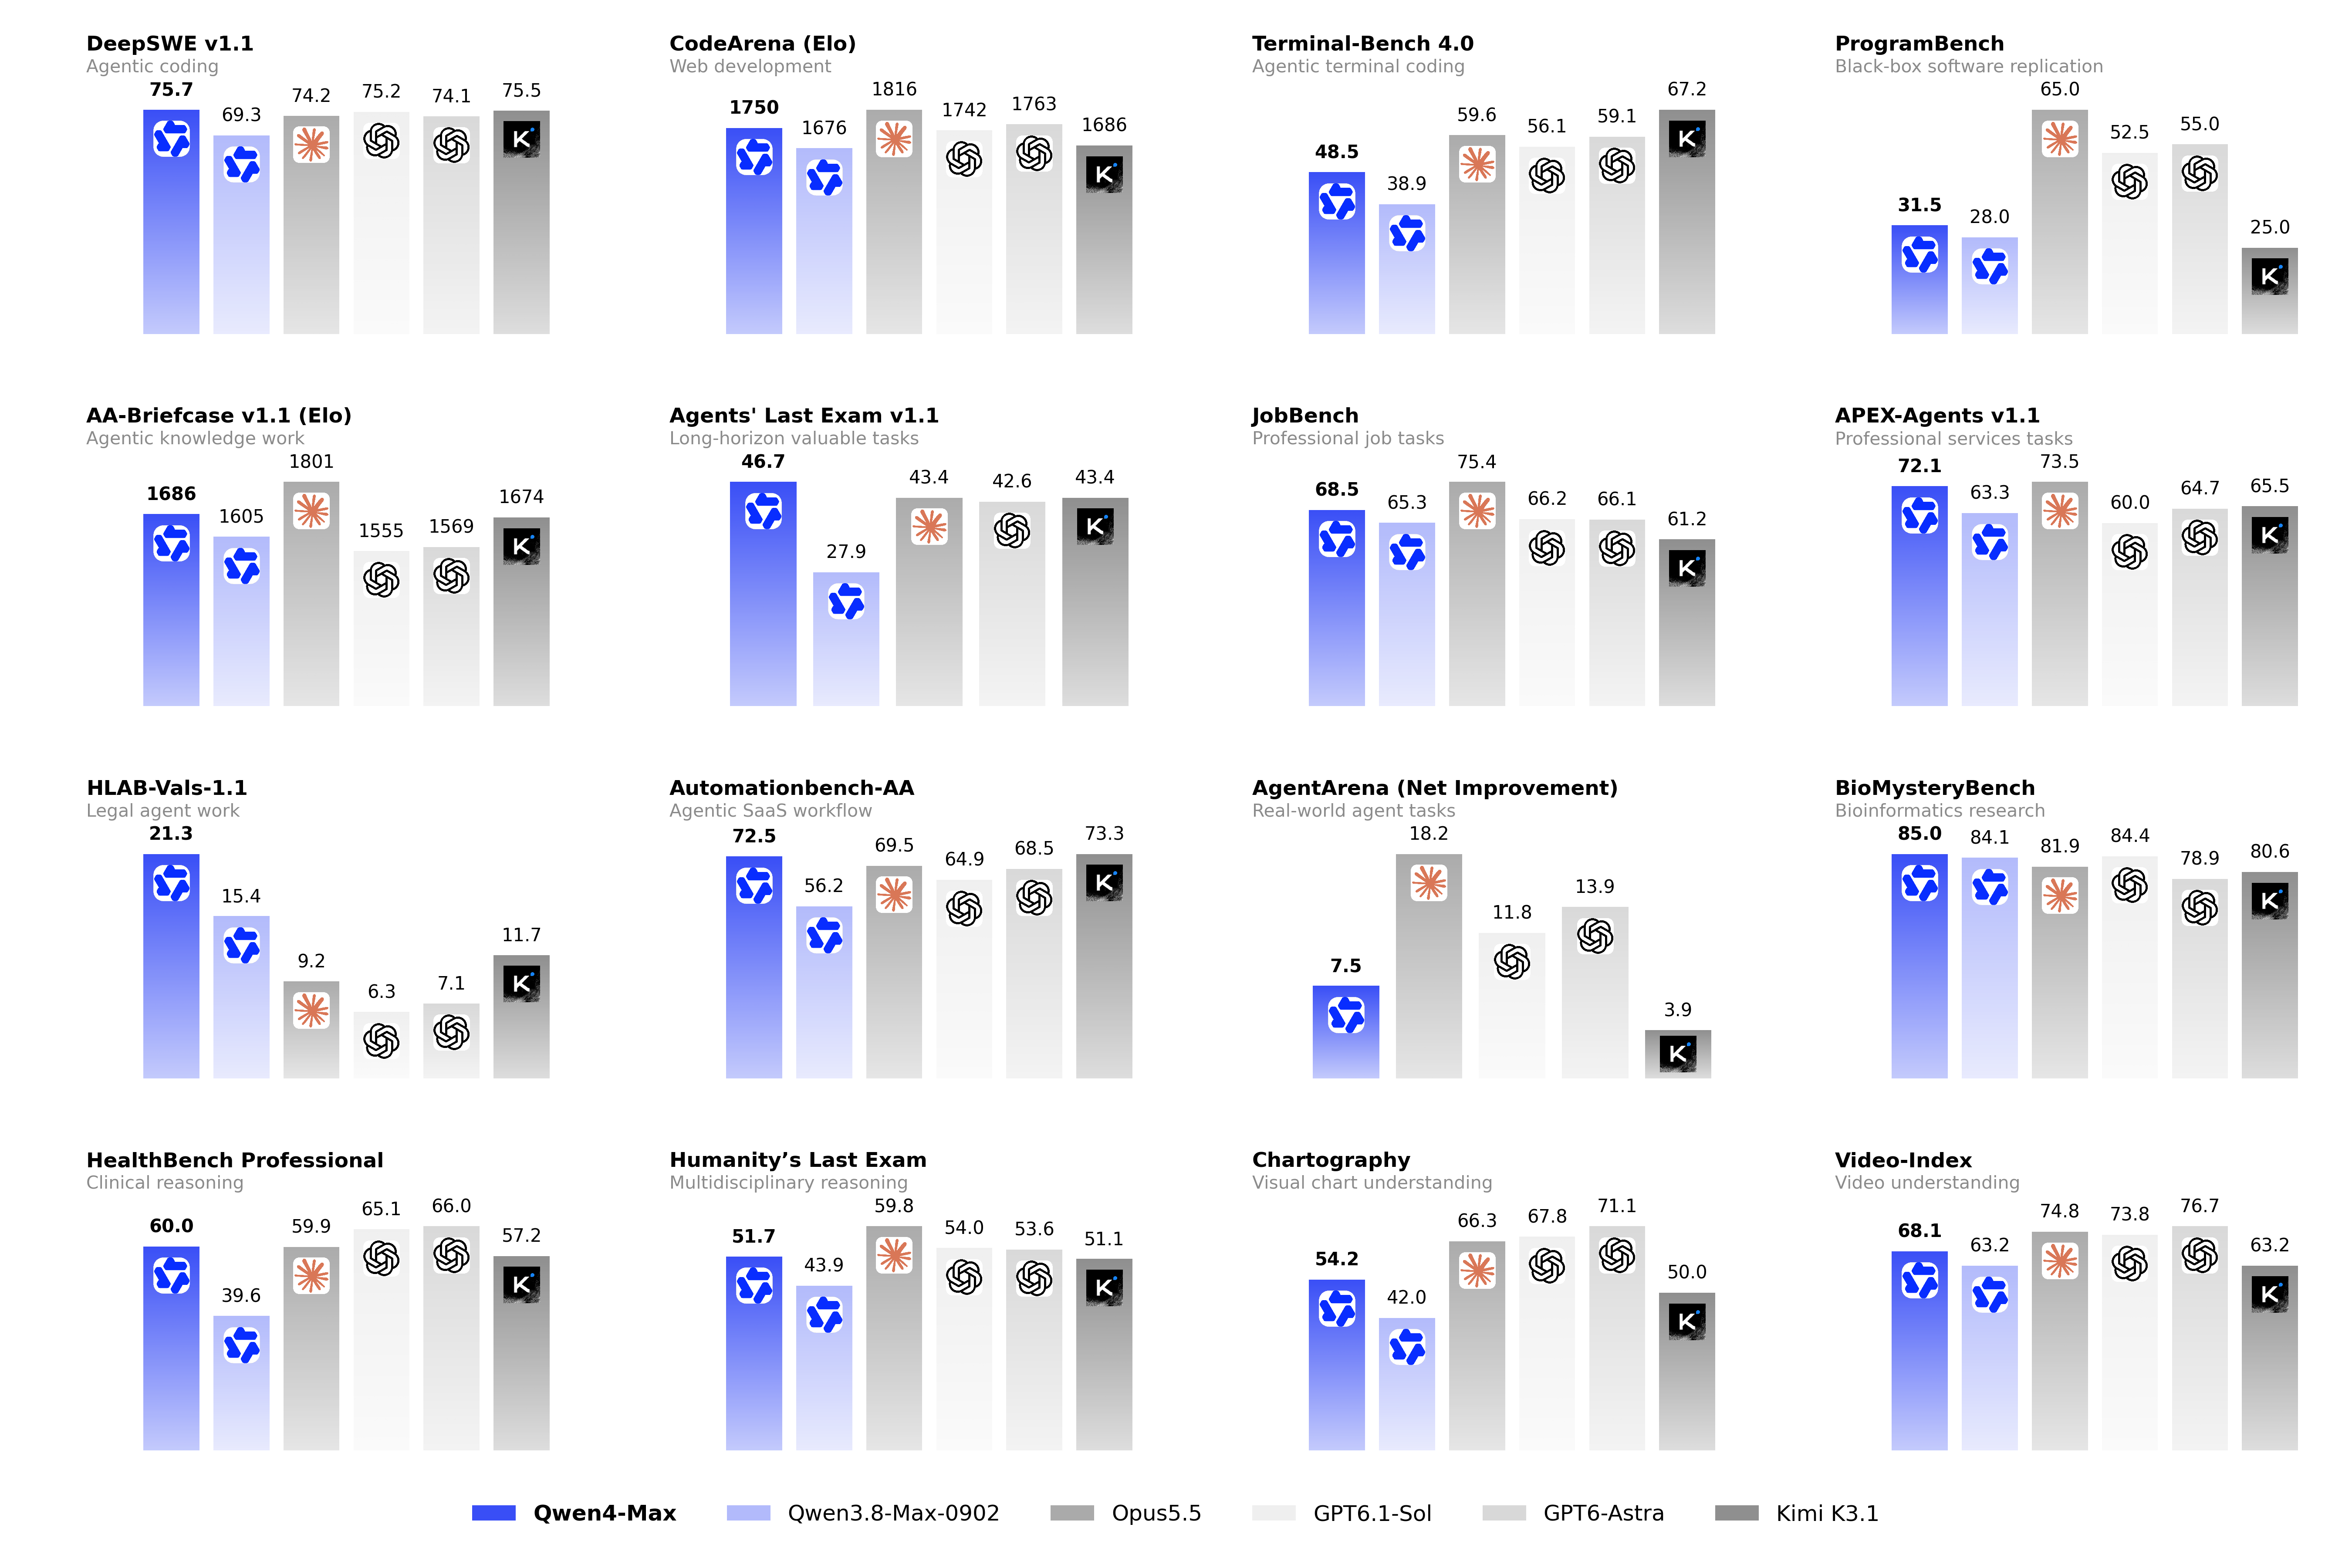
部落格的主圖比較六個模型在 16 項評測的分數。下表依圖轉錄,類型譯自圖上的副標,粗體是各列最高分,出處依部落格的註腳。
| 評測 | 類型 | Qwen4-Max | Qwen3.8-Max-0902 | Claude Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 | 出處 |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 | agent 寫程式 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 | 未註明 |
| CodeArena(Elo) | 網頁開發 | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 | Arena |
| Terminal-Bench 4.0 | 終端機 agent 寫程式 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 | 未註明 |
| ProgramBench | 黑箱軟體複製 | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 | 未註明 |
| AA-Briefcase v1.1(Elo) | agent 知識工作 | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 | Artificial Analysis |
| Agents’ Last Exam v1.1 | 長時程任務 | 46.7 | 27.9 | 43.4 | 42.6 | — | 43.4 | Agents’ Last Exam 排行 |
| JobBench | 專業工作任務 | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 | 未註明,用更新後的資料集與評測程式碼 |
| APEX-Agents v1.1 | 專業服務任務 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 | Mercor 排行 |
| HLAB-Vals-1.1 | 法律 agent 工作 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 | Vals Index |
| AutomationBench-AA | agent 處理 SaaS 工作流程 | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 | Artificial Analysis |
| AgentArena(淨改善) | 真實世界 agent 任務 | 7.5 | — | 18.2 | 11.8 | 13.9 | 3.9 | Arena |
| BioMysteryBench | 生物資訊研究 | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 | 未註明 |
| HealthBench Professional | 臨床推理 | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 | 未註明 |
| Humanity’s Last Exam | 跨學科推理 | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 | 未註明 |
| Chartography | 圖表理解 | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 | 未註明,Qwen 兩個模型的 min_pixels 設為 4096×32×32 |
| Video-Index | 影片理解 | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 | 未註明 |
Qwen4-Max 拿到最高分的 4 項是 DeepSWE v1.1、Agents’ Last Exam v1.1、HLAB-Vals-1.1 和 BioMysteryBench。其中兩項的差距很小:DeepSWE 只比 Kimi K3.1 高 0.2 分,BioMysteryBench 只比 GPT-6.1 Sol 高 0.6 分。圖上沒有標示誤差範圍,看不出這樣的差距是否超出測量誤差。另外兩項的差距較大,Agents’ Last Exam 比次高分多 3.3 分,HLAB-Vals 的 21.3 分比上一代 Qwen3.8-Max 的 15.4 分高 5.9 分,約是外部對手最高分(Kimi K3.1 的 11.7 分)的 1.8 倍。這兩項都註明引自外部排行。
Qwen4-Max 落後最多的兩項都是程式任務。Terminal-Bench 4.0 測 agent 在終端機裡完成程式任務,Qwen4-Max 得 48.5 分,四個外部對手都在 56 分以上,最高的 Kimi K3.1 是 67.2 分。ProgramBench 在圖上標為黑箱軟體複製(black-box software replication),Qwen4-Max 得 31.5 分,Claude Opus 5.5 的 65.0 分約是它的兩倍,四個外部對手裡只有 Kimi K3.1 的 25.0 分比它低。新聞稿說 Qwen4-Max 在多項主要評測名列前茅,尤其是程式、agent 任務和視覺推理,並在成績亮眼的評測裡列出 Chartography;表上 Qwen4-Max 的 Chartography 是 54.2 分,比最高的 GPT-6 Astra 低 16.9 分,Video-Index 也低 8.6 分。
除了上述領先的 4 項和兩項程式任務,其餘 10 項 Qwen4-Max 排在第二到第四名。依表上的最高分計,Claude Opus 5.5 領先 7 項,是六個模型裡最多的。和上一代相比,兩者都有分數的 15 項,Qwen4-Max 全部較高;AgentArena 沒有 Qwen3.8-Max 的分數。
16 項中有 7 項註明引自外部排行:CodeArena 和 AgentArena 引自 Arena,AA-Briefcase 和 AutomationBench-AA 引自 Artificial Analysis,APEX-Agents 引自 Mercor 排行,HLAB-Vals 引自 Vals Index,Agents’ Last Exam 引自它自己的排行。其餘 9 項,部落格沒有註明外部出處。Qwen4-Max 領先的 4 項裡,DeepSWE 和 BioMysteryBench 都沒有註明出處。部落格也沒有說主圖用哪一檔推理強度(effort),或 agent 評測用什麼執行框架(harness)。Terminal-Bench 4.0 的 48.5 分和下一節效率圖上 Xhigh 檔的分數相符,其他項目無從對照。
效率:Work360 與 token 用量
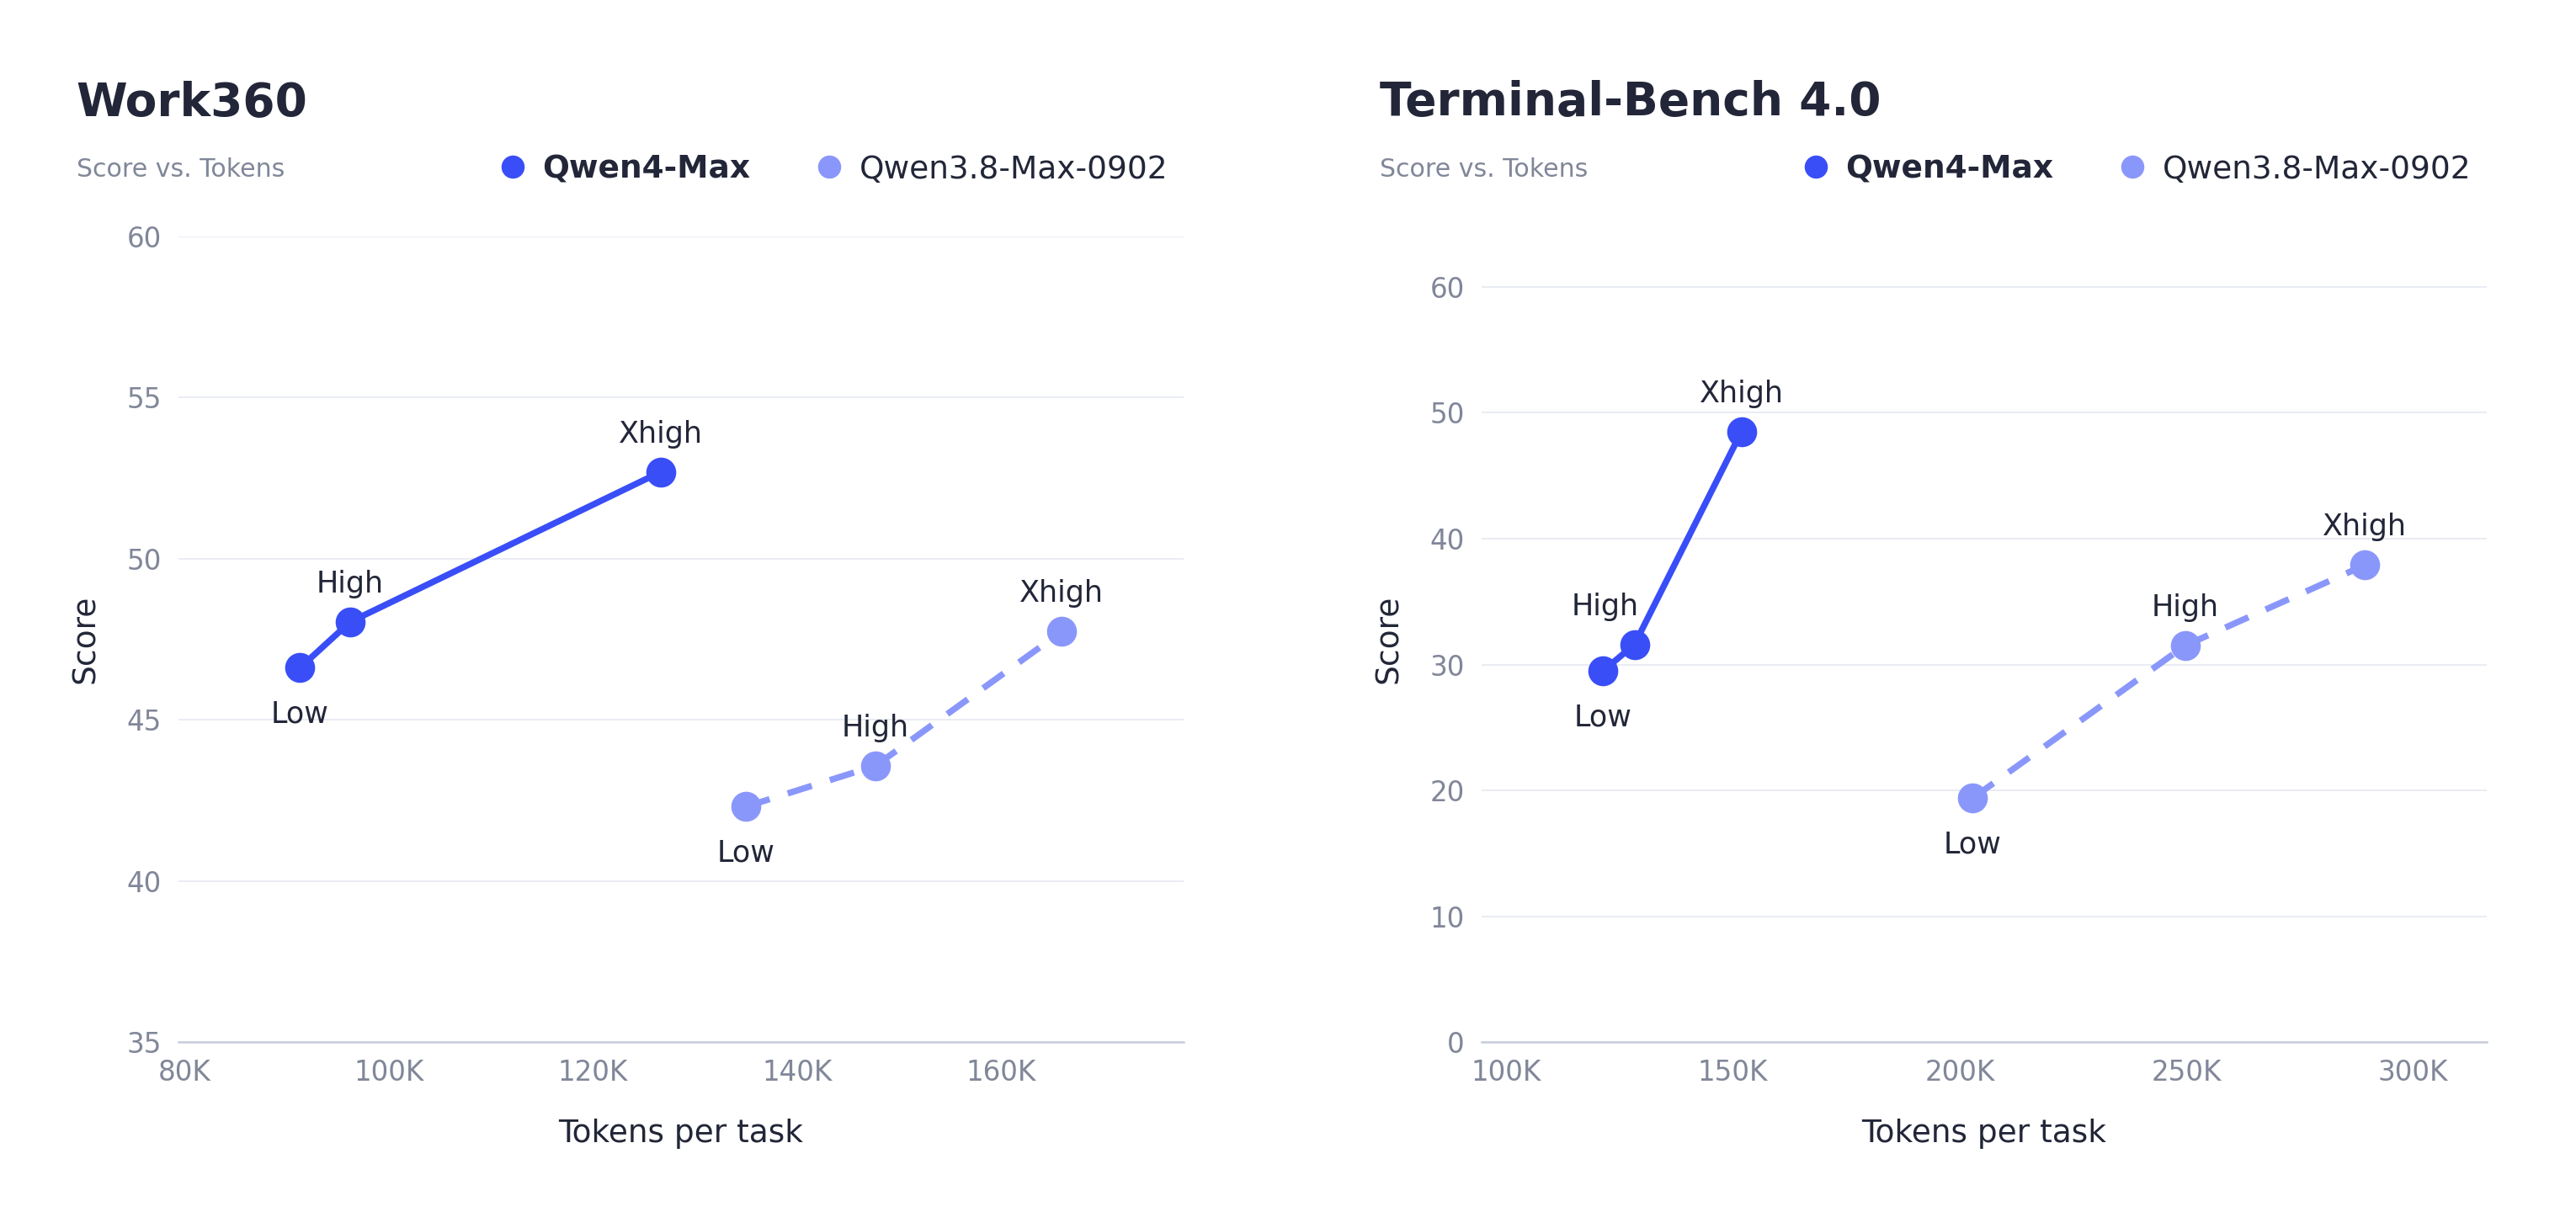
Work360 是阿里巴巴自建的評測架構,把工作情境分成 26 個一級領域、182 個二級子領域和 721 個三級專業領域。Qwen4-Max 在 Work360 得 52.69 分,Qwen3.8-Max 是 47.74 分。部落格沒有說 Work360 有多少題。
token 用量的比較分成兩檔推理強度。在 Work360,Qwen4-Max 用的 token 在 Xhigh 檔少約 24%,在 High 檔少約 35%;在 Terminal-Bench 4.0,兩檔分別少約 48% 和 49%。依部落格的分數對 token 散布圖判讀,Work360 的 Low、High、Xhigh 三檔,Qwen4-Max 的分數都比 Qwen3.8-Max 高。Terminal-Bench 4.0 的 High 檔兩者都是 30 分出頭,Qwen4-Max 用的 token 約為一半;Xhigh 檔則是 Qwen4-Max 約 48 分,Qwen3.8-Max 約 38 分。
部落格說,在 Work360 上每題平均成本從 4.43 美元降到 1.67 美元,減少 62%;新聞稿寫約 60%。依部落格的兩個數字計算,降幅是 62.3%,大於 token 用量的降幅。部落格在同一段提到 API 降價,但沒有拆開兩者各占多少,也沒有寫這個成本用哪一檔推理強度計算。
安全:只有程式碼安全有數字
部落格的安全段,只有程式碼安全附了數字。在 Last Secure Code Bench「沒有安全提示的程式碼重建」與「功能與漏洞雙重驗證」兩項設定下,函式層級同時通過功能與安全檢查的比例,從 Qwen3.8-Max 的 22.0% 升到 31.8%;在函式、檔案、儲存庫三個層級都安全產生程式碼的比例,從 8% 升到 14.7%。換句話說,函式層級仍有約 68% 的程式碼沒有同時通過兩種檢查。
資安方面,部落格說訓練資料依任務目的過濾,保留漏洞驗證、偵測與修補這類防禦任務的資料,移除用來提升攻擊能力的資料,並說沒有觀察到可能造成大規模資安風險的能力。化學、生物、放射性與核子(CBRN)方面,部落格說設計了專門的安全資料,並在安全後訓練階段加強;內部評測顯示安全回應增加,沒有過度拒答,也沒有發現模型把相關知識轉成對使用者能力的顯著提升。資安和 CBRN 都沒有公布數字,結論來自阿里巴巴的內部評估。
第三方排行
新聞稿說 Qwen4-Max 在 Code Arena(即表上的 CodeArena)排第 6 名,也把 Vals Index 列在它成績亮眼的評測裡。Vals Index 11 月 15 日更新的排行裡,Qwen4-Max 以 63.20% 排第 11 名。官方圖上的外部對手,Claude Opus 5.5 是 70.14%(第 4 名),GPT-6 Astra 是 65.02%(第 8 名),GPT-6.1 Sol 是 63.94%(第 10 名),都比 Qwen4-Max 高;Kimi K3.1 Pro 是 62.52%(第 12 名),比它低。排行榜上的 Kimi 是 K3.1 Pro,官方圖只寫 Kimi K3.1,兩者可能是不同版本。第 1 名是 Claude Fable 5.2,71.31%。
官方圖上的 HLAB-Vals-1.1 引自 Vals,Qwen4-Max 在圖上的六個模型裡最高。Vals 的 HLAB-Vals-1.1 排行上,Qwen4-Max 是 21.25%,排第 7 名。
Artificial Analysis 的 Intelligence Index 給 Qwen4-Max 43 分。同一份排行的前五名是 Claude Fable 5.2(max)65 分、Gemini 4 Carbon(high)60 分、Claude Opus 5.5(max)59 分、GPT-6 Astra(max)57 分和 GPT-6.1 Sol(max)55 分。Qwen4-Max 的頁面沒有標示測試時用哪一檔推理強度。Artificial Analysis 也列出 Qwen4-Max 跑這份指數的每題平均成本 3.27 美元,共輸出 1.27 億 token。這是另一組題目上的成本,不能和 Work360 的 1.67 美元直接比較。
限制
Qwen4-Max 不開放權重,外部只能透過 API 使用和測試,無法自行部署或檢查權重。
官方資料有三處無法核對。主圖有 9 項沒有註明外部出處,也沒有寫推理強度、執行框架和誤差範圍。Work360 是自家評測,部落格沒有說題數,62% 的成本降幅只在這個評測上算出。架構只有部落格的幾句說明,沒有技術報告可以核對。
參考資料
- Qwen:Qwen4-Max: Your New Teammate Has Arrived(2026-11-16),主圖見評測圖檔,效率圖見token 效率圖檔
- Alibaba Cloud:Alibaba Unveils Qwen4-Max: New AI Teammate for Work, Creativity, and Discovery(2026-11-16)
- QwenCloud:Qwen4-Max 模型頁、API 價格、Model prices 文件
- Hugging Face:Qwen/Qwen3.8-2.4T-A95B 模型卡
- Vals AI:Vals Index、HLAB-Vals-1.1
- Artificial Analysis:Qwen4 Max、Models